Un résultat médical affichant une valeur p de 0,03 attire souvent l’attention, comme s’il suffisait à confirmer l’efficacité d’un traitement. Pourtant, ce nombre ne dit ni si le bénéfice est important pour les patients, ni si l’étude est exempte de biais.
La valeur p est un outil statistique utile, à condition de la replacer dans son contexte. Sa lecture doit être associée à la taille de l’effet, à l’intervalle de confiance, à la qualité de l’étude et aux conséquences concrètes du résultat en pratique médicale.
Qu’est-ce que la valeur p ?
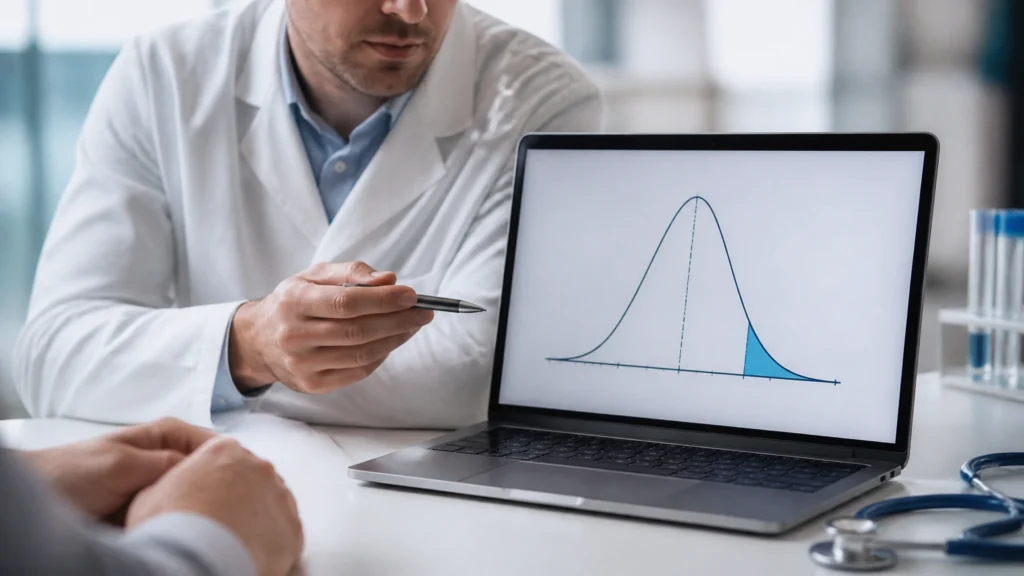
La valeur p, aussi appelée p-value, indique la probabilité d’obtenir un résultat au moins aussi éloigné de l’hypothèse de départ que celui observé, en supposant que cette hypothèse soit vraie. Dans la plupart des études médicales, l’hypothèse nulle correspond à une absence de différence, d’association ou d’effet entre les groupes comparés.
Imaginons un essai clinique dans lequel un médicament est comparé à un placebo pour réduire la tension artérielle. L’hypothèse nulle affirme que les deux traitements ont, en moyenne, le même effet. Si l’analyse produit une valeur p de 0,03, cela signifie que des résultats aussi marqués, ou davantage, seraient observés dans environ 3 % des cas si aucune différence réelle n’existait, selon le modèle statistique utilisé.
Cette définition exclut plusieurs interprétations courantes. Une valeur p de 0,03 ne signifie pas qu’il n’y a que 3 % de chances que l’hypothèse nulle soit vraie, ni que le traitement a 97 % de chances d’être efficace. Elle ne mesure pas non plus directement le risque de se tromper dans la décision médicale.
Une valeur p décrit la compatibilité des données avec une hypothèse statistique, et non la vérité définitive d’une explication médicale.
À quoi sert-elle dans les études de santé ?
La valeur p aide les chercheurs à évaluer si les données recueillies sont suffisamment éloignées de ce qui serait attendu en l’absence d’effet. Elle peut être utilisée dans un essai randomisé, une étude de cohorte, une enquête épidémiologique ou une méta-analyse, avec des méthodes adaptées à chaque type de données.
Elle intervient notamment lorsqu’il s’agit de comparer deux traitements, d’étudier une association entre une exposition et une maladie ou d’évaluer l’effet d’une intervention de prévention. Elle peut aussi accompagner une analyse de corrélation, une régression, un test du chi carré ou une comparaison de moyennes.
- Comparer la fréquence d’un événement entre un groupe traité et un groupe témoin.
- Examiner l’association entre un facteur de risque et une maladie.
- Évaluer une différence de symptômes, de tension artérielle ou de mortalité.
- Rechercher l’influence d’une intervention de santé publique.
Le seuil de 0,05 est souvent utilisé pour décider si un résultat est qualifié de statistiquement significatif. Toutefois, ce seuil reste une convention. Une valeur p de 0,049 et une valeur p de 0,051 sont pratiquement voisines, même si la première est parfois présentée comme positive et la seconde comme négative.
| Valeur p | Lecture prudente | Conclusion à éviter |
|---|---|---|
| p < 0,01 | Les données sont peu compatibles avec l’hypothèse nulle, dans le cadre du modèle choisi. | L’effet est forcément important ou utile. |
| p entre 0,01 et 0,05 | Le résultat est souvent décrit comme statistiquement significatif. | Le traitement est nécessairement supérieur, sûr ou recommandé. |
| p ≥ 0,05 | Les données ne permettent pas de rejeter l’hypothèse nulle au seuil retenu. | Il n’existe absolument aucun effet. |
Signification statistique et intérêt clinique
La signification statistique et la pertinence clinique répondent à deux questions différentes. La première porte sur la compatibilité des observations avec l’absence d’effet, tandis que la seconde cherche à savoir si la différence constatée change réellement la prise en charge ou la vie des patients.
Une étude menée auprès de 50 000 personnes peut détecter une différence minuscule avec une valeur p très faible. Par exemple, une baisse moyenne de la douleur de 0,2 point sur une échelle de 10 peut être statistiquement certaine sans apporter un bénéfice perceptible.
À l’inverse, une étude de petite taille peut mettre en évidence une amélioration potentiellement importante sans atteindre le seuil de 0,05. Ce résultat peut refléter une puissance statistique insuffisante, une grande variabilité entre les participants ou un nombre trop faible d’événements observés.
Pour juger l’intérêt réel d’un traitement, il faut donc examiner la différence absolue entre les groupes, le risque relatif, le nombre nécessaire à traiter et la fréquence des effets indésirables. La valeur p ne permet pas, à elle seule, de savoir si un bénéfice est assez grand pour justifier les contraintes, le coût ou les risques associés au traitement.
Pourquoi regarder l’intervalle de confiance ?
L’intervalle de confiance complète la valeur p en donnant une idée de la précision de l’estimation. Un intervalle de confiance à 95 % présente une plage de valeurs compatibles avec les données et la méthode employée, même s’il ne doit pas être interprété comme la probabilité que la vraie valeur se trouve dans cet intervalle.
Supposons qu’un traitement réduise le risque relatif d’un événement de 10 %, avec un intervalle de confiance allant de 2 % à 18 %. L’effet semble orienté dans le sens d’une réduction, mais son ampleur exacte reste incertaine. Cette information est beaucoup plus instructive qu’une simple mention indiquant « p < 0,05 ».
Pour une différence de moyennes, la valeur nulle est généralement 0. Pour un risque relatif, un odds ratio ou un hazard ratio, elle est généralement égale à 1. Lorsque l’intervalle traverse cette valeur nulle, les données restent compatibles avec l’absence d’effet au niveau de confiance choisi.
Un intervalle très large doit également inciter à la prudence. Il peut signaler un échantillon trop petit, des mesures instables ou une forte diversité des profils étudiés. Un résultat non significatif n’est donc pas forcément inutile, mais il doit être présenté comme imprécis plutôt que comme la preuve d’une absence d’effet.
Les erreurs fréquentes d’interprétation
La première erreur consiste à dire qu’une valeur p de 0,05 signifie que les résultats ont 5 % de chances d’être dus au hasard. Le calcul repose sur l’hypothèse nulle et ne fournit pas directement la probabilité que cette hypothèse soit vraie.
La deuxième erreur revient à considérer une valeur p élevée comme une preuve d’inefficacité. Avec p = 0,20, l’étude n’apporte pas suffisamment d’éléments pour rejeter l’hypothèse nulle, mais elle ne démontre pas pour autant qu’aucun effet n’existe.
La troisième erreur est de confondre une association avec une relation de cause à effet. Dans une étude observationnelle, une valeur p très faible peut accompagner une association réelle, mais celle-ci peut aussi être influencée par un facteur de confusion, un biais de sélection ou une différence initiale entre les groupes.
Enfin, les expressions comme « tendance vers la significativité » peuvent donner une importance excessive à un résultat proche du seuil. Une analyse sérieuse doit présenter la valeur exacte, l’estimation de l’effet, son intervalle de confiance et les hypothèses qui avaient été définies avant l’analyse.
L’influence de la taille de l’échantillon
La taille de l’échantillon joue un rôle majeur dans la valeur p. Plus une étude inclut de participants, plus elle peut détecter de petites différences, à condition que les mesures soient fiables et que le protocole soit correctement conçu.
Dans une petite étude, un effet réel peut rester difficile à distinguer du bruit statistique. Les chercheurs parlent alors de manque de puissance, mais ce terme ne signifie pas nécessairement que le traitement est inefficace. Il indique plutôt que les données disponibles ne permettent pas de trancher avec suffisamment de précision.
La situation inverse existe également : une étude très vaste peut rendre statistiquement significative une différence sans intérêt pratique. La taille de l’effet et la pertinence clinique doivent donc toujours accompagner la valeur p, quel que soit le nombre de participants.
Le problème des comparaisons multiples
Lorsqu’une équipe teste de nombreuses hypothèses, la probabilité d’obtenir au moins un résultat inférieur à 0,05 par le seul effet du hasard augmente. Une étude qui examine vingt critères indépendants peut ainsi produire un résultat apparemment significatif sans qu’il corresponde à un effet véritable.
Pour limiter ce risque, les chercheurs peuvent définir à l’avance un critère principal, distinguer les analyses confirmatoires des analyses exploratoires et appliquer une correction statistique. La correction de Bonferroni est l’une des méthodes possibles, même si d’autres approches peuvent être préférées selon le contexte.
La transparence est essentielle : une publication doit préciser le nombre d’analyses réalisées, les résultats non significatifs et les éventuelles modifications du protocole. Sans cette information, une valeur p favorable peut donner une image trop optimiste des résultats.
- Le critère principal était-il défini avant le début de l’étude ?
- Combien de comparaisons ont été effectuées ?
- Les résultats négatifs ou indéterminés sont-ils présentés ?
- Les analyses secondaires sont-elles clairement identifiées ?
Une méthode simple pour lire un résultat médical
La lecture peut commencer par la question clinique : quel problème l’étude cherche-t-elle réellement à résoudre ? Il faut ensuite vérifier la population étudiée, le type de comparaison, la durée du suivi et le critère mesuré.
La valeur p vient seulement après cette première vérification. Il est préférable de regarder simultanément la taille de l’effet et l’intervalle de confiance, puis d’évaluer la cohérence du résultat avec les autres études disponibles.
Les effets indésirables méritent la même attention que le bénéfice principal. Un médicament peut améliorer légèrement un symptôme tout en augmentant un risque grave, ce qui change complètement son intérêt pour les patients.
La qualité méthodologique compte également : randomisation, insu, données manquantes, durée du suivi et respect du protocole peuvent modifier la confiance accordée aux résultats. Les ressources de la Cochrane, de la National Library of Medicine, des NIH et du BMJ recommandent toutes de ne pas isoler la valeur p du reste de l’analyse.
Ce que le chiffre permet vraiment de dire
La valeur p reste pertinente lorsqu’elle répond à une hypothèse définie à l’avance et qu’elle s’appuie sur une méthode statistique adaptée. Elle aide à apprécier la compatibilité des données avec l’absence d’effet, mais elle ne remplace ni le jugement clinique ni l’évaluation globale des preuves.
Pour interpréter un résultat de santé avec sérieux, il faut réunir plusieurs informations : ampleur du bénéfice, précision de l’estimation, risques associés, qualité de l’étude et applicabilité aux patients concernés. La bonne question n’est donc pas seulement de savoir si p est inférieur à 0,05, mais de déterminer si l’effet est suffisamment fiable, important et utile pour guider une décision.
FAQ
Une valeur p de 0,03 indique que, si l’hypothèse nulle était vraie, des résultats aussi éloignés ou davantage seraient observés dans environ 3 % des cas.
Non, une valeur p inférieure à 0,05 indique seulement que les données sont peu compatibles avec l’absence d’effet selon le modèle utilisé, sans prouver l’efficacité ou l’utilité clinique.
La signification statistique concerne la compatibilité des données avec l’hypothèse nulle, tandis que la pertinence clinique évalue l’importance réelle du bénéfice pour les patients et la prise en charge.
L’intervalle de confiance renseigne sur la précision de l’estimation et sur les amplitudes d’effet compatibles avec les données, ce qu’un seuil statistique seul ne permet pas d’apprécier correctement.
Non, un résultat supérieur ou égal à 0,05 ne permet pas de rejeter l’hypothèse nulle au seuil choisi, mais il ne démontre pas qu’aucun effet réel n’existe.